CallLens
Дзвінки продажів: транскрипція, оцінка LLM і пошук за змістом
Кожен дзвінок відділу продажів транскрибований, оцінений і доступний для пошуку. CallLens приймає дзвінок через підписаний вебхук, транскрибує з діаризацією, оцінює кожного менеджера за конфігурованим scorecard через LLM зі структурованим виходом, будує ембеддинги для семантичного пошуку та подає все це в кабінеті з аналітикою на Cube. Жодних GPU. Один сервер на Hetzner.
- Галузь
- ШІ · SaaS
- Технології
- Symfony 7.4 · PostgreSQL 17 · Next.js 15 · Cube
- GPU потрібно
- 0
- Розмір вектора
- 1024
- Етапів пайплайну
- 5
- Вартість інфри/міс
- ≈€60
Коучинг Продажів, Що Дійсно Читає Дзвінки
Більшість команд продажів записують дзвінки. Майже ніхто не оцінює їх послідовно — у менеджерів немає годин, а scorecard'и самі не застосовуються. CallLens автоматизує читання: кожен дзвінок прийнятий, кожен менеджер оцінений, кожне заперечення можна знайти.
Ми побудували це за принципом cheap-by-design: уся важка ШІ-робота йде через зовнішні HTTP API (Deepgram для STT, OpenAI для скорингу + ембеддингів), GPU не потрібна, одного сервера Hetzner достатньо. Інтерфейси, незалежні від провайдера, дозволять згодом замінити або self-host без зачіпання бізнес-логіки.
Надійно оцінювати дзвінки продажів LLM, що ніколи не вигадує цитату-доказ, зберігати 1024-dim ембеддинги для семантичного пошуку в масштабі, дати менеджерам кабінет аналітики на Cube — і зробити це все на одному сервері Hetzner, одним Docker-стеком і без GPU.
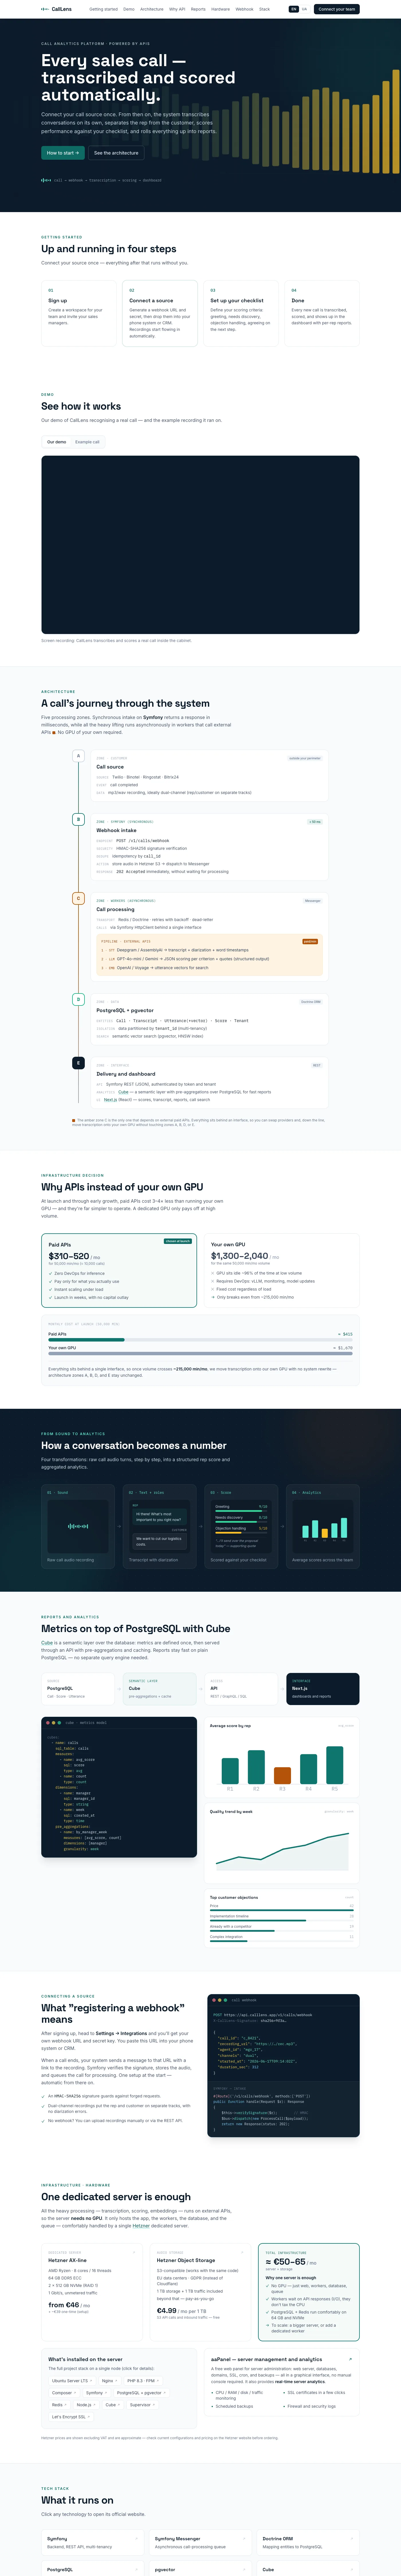
Symfony 7.4 + PHP 8.5 на PostgreSQL 17 + pgvector (HNSW), API Platform генерує OpenAPI 3.1, пайплайн Messenger проводить кожен дзвінок через стани transcribe → score → embed (ідемпотентно, з повторами), Cube як семантичний шар аналітики, та кабінет на Next.js 15 зверху. Скорер фіксує структурований JSON-вихід і перевіряє, що кожна цитата-доказ існує в реальному транскрипті.
Створено для Sales-Менеджера
- 01
Вебхук + Ручне завантаження
Підписані HMAC вебхуки з будь-якої телефонії/CRM (Twilio, Binotel, Ringostat, Bitrix24) та ручне завантаження через REST. Ідемпотентно за tenant + зовнішнім ID дзвінка.
- 02
Транскрипція з Діаризацією
Deepgram для STT з мітками по каналах для dual-channel audio та провайдерською діаризацією для моно. Тайминги слів зберігаються для кожного висловлювання.
- 03
LLM-Скоринг з Доказами
Скоринг по кожному критерію зі строгою JSON-схемою, цитата-доказ для кожної оцінки, цитата перевіряється на присутність у транскрипті. Жодних оцінок «на вайбі».
- 04
Семантичний Пошук
pgvector ембеддинги 1024-dim для кожного висловлювання, HNSW індекс, tenant-scoped ANN. Запитайте «де менеджер опрацював заперечення» — отримайте реальні моменти.
- 05
Аналітика на Cube
Попередньо агреговані дашборди над Postgres — середній скор по менеджеру, тренд у часі, топ заперечень, розподіл оцінок. Без другого пошукового двигуна для звітів.
- 06
Конфігурована Ретенція Аудіо
keep, delete-after-processing або delete-after-N-days, на tenant. Sweeper працює щоночі; транскрипти і скори лишаються навіть після видалення аудіо.
Подивіться в Дії

Під Капотом
Один Docker-стек, одна машина Hetzner, один Postgres. Уся важка ШІ-робота йде через зовнішні API за вузькими інтерфейсами — змінюйте провайдера в одному рядку конфігу або переходьте на self-hosted GPU, коли крива витрат перетне (~215к хв аудіо/міс).
- Symfony 7.4
- API PHP 8.5 + Workflow
- PostgreSQL 17
- + pgvector (HNSW)
- Next.js 15
- Лендінг + docs + кабінет
- Cube
- Аналітика над Postgres
Потрібні ШІ-Native інструменти команді?
Від коучингу продажів до аналітики саппорту, ми запускаємо ШІ-продукти, що роблять важку роботу правильно — суворі структуровані виходи, відповіді з доказами та стеки, які реально можна обслуговувати.
Sonrisa Blanca
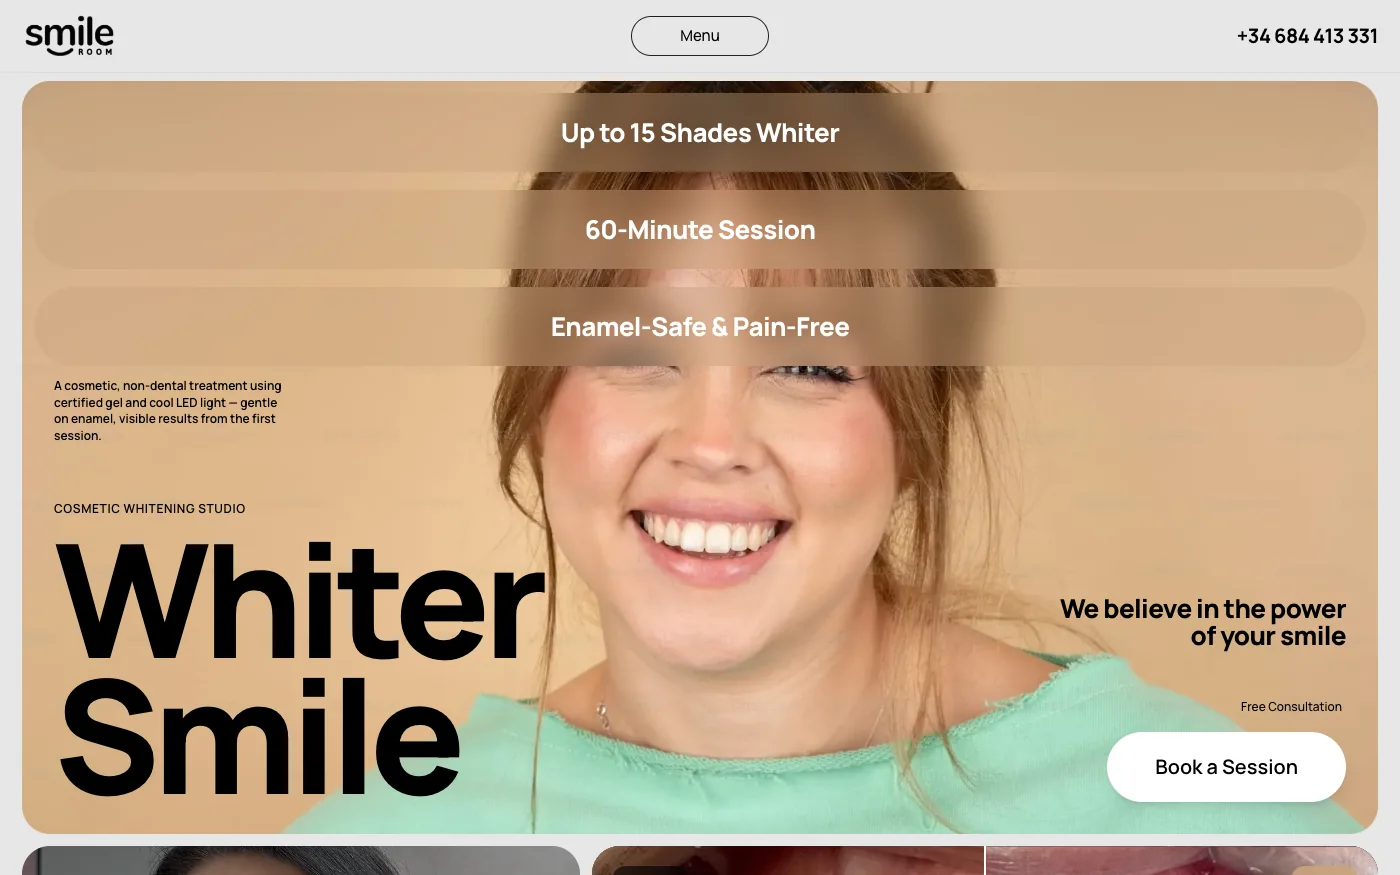
Сайт студії відбілювання зубів з акцентом на записи
Поговорімо про проєкт.
Розкажіть, що ви будуєте. Відповідь і першу оцінку отримаєте протягом 24 годин.
Заповнити бриф →